Cafeína: resultados iniciais
(AI foi usada como apoio na preparação desse artigo: revisão gramatical e ortográfica, análise dos dados e geração dos gráficos. Mas não é um artigo escrito por AI.)
O Cafeina começou como um utilitário para prevenir a hibernação do Windows enquanto minhas queries rodavam… na minha era “pré-Databricks”, onde meu ambiente de dados era o SQL Server e acessava os dados via SMSS. Um projeto simples, python empacotado em um executável Windows, front end simples, escondido na bandeja.
A primeira versão “manual” simulava aperto de teclas aleatórias no sistema ou pequenos movimentos do mouse. A segunda versão, ainda manual, já mais esperta, alterava os parâmetros do sistema informando o Windows para não desligar. Meu time e outros colegas de trabalho passamos a usar o utilitário.
Em setembro de 2025 li a notícia de que o Itaú estava monitorando seus funcionários via controle de cliques (e isso causou algumas demissões), e, como brincadeira, coloquei o primeiro tracking de cliques e distância percorrida do mouse na tela – para sabermos o quanto estamos usando.
No mesmo momento veio a ideia: o mesmo gancho de teclado que conta teclas podia medir como eu digito. E a pergunta: será que consigo construir um perfil de uso de mouse e teclado que identifique meu estilo de uso? Se sim, posso criar um algoritmo que, por exemplo, bloqueie meu notebook se detectar um estilo de uso que não é meu. Até antes da AI era uma ideia legal, mas algo que demandaria tempo e não conseguiria me dedicar a isso no meio das demandas do dia a dia – mas essa ideia, com a chegada da AI, pode virar realidade.
Comecei com algumas medidas simples de estilo de digitação:
- Frequência de teclas pressionadas
- Pontos de uso de mouse na tela
- Registro de bigramas e trigramas de sequência de teclas
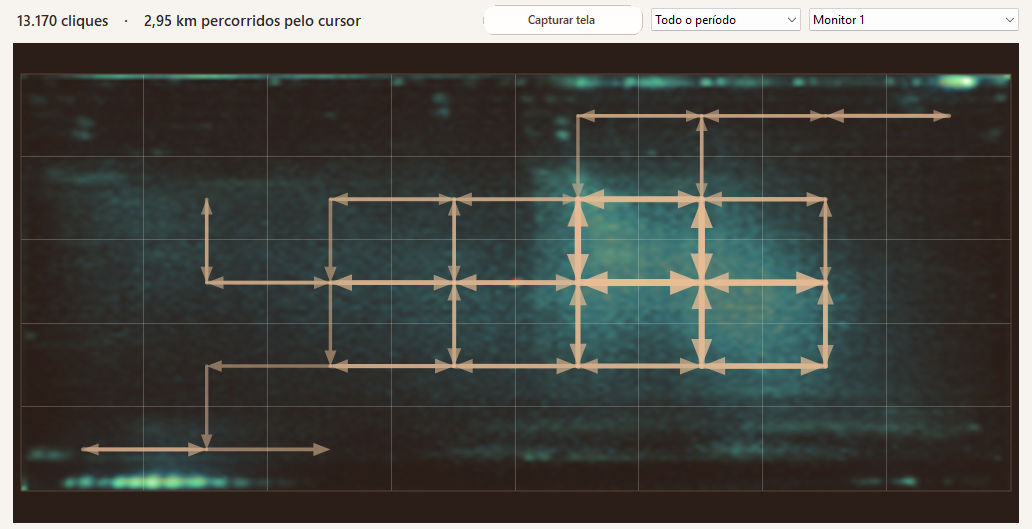
Regiões de uso, movimentos padrão na tela e pontos de descanso do cursor
Primeiras conclusões após um período de coleta:
- Tracking de movimentos de mouse é dependente do hardware usado, não apenas do usuário. Em casa uso um monitor widescreen, no escritório uso um monitor menor – a solução foi criar “identidade”, que é composta por usuário e setup utilizado, para coleta de dados
- Precisaria coletar dados de outras pessoas para realizar testes e comparar diferentes perfis. Soluções:
- Para coletar dados de mais pessoas subi um backend em meu servidor para receber dados via API. O app local envia os dados
- Essas informações coletadas são biométricas e permitem identificar uma pessoa (é o que queremos) – preciso de uma política de privacidade mínima para garantir alinhamento com LGPD, anonimização e a possibilidade de um participante revogar o consentimento dos dados e apagar o que foi carregado
- Ainda na linha privacidade, nem a coleta dos dados nem o envio para o servidor são automáticos – a coleta precisa ser ativada pelo usuário e cada upload é feito manualmente, precisando do consentimento do usuário da política de privacidade
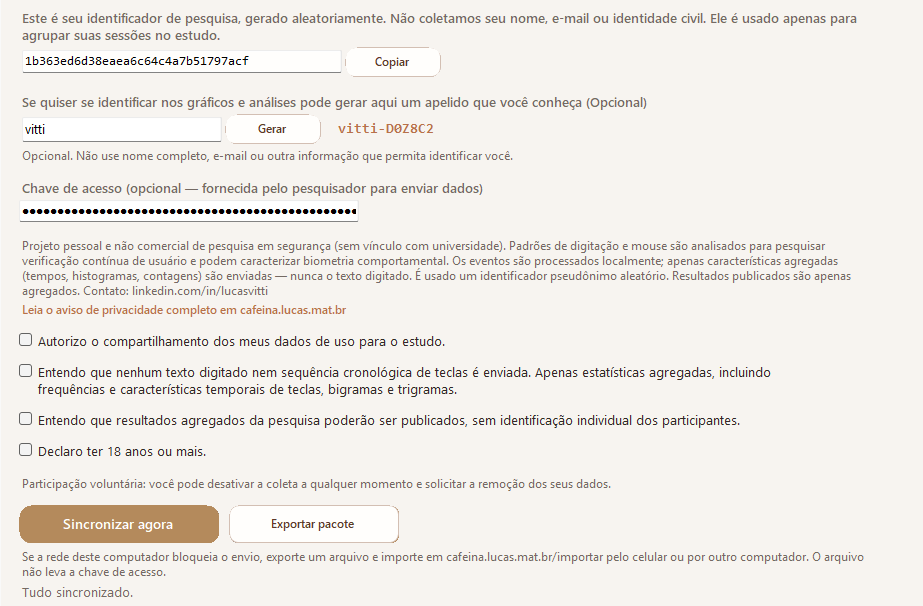
Tela para upload de dados. Exige consentimento explícito a cada envio dos dados para a pesquisa
O que o cafeína coleta
Três informações do teclado.
Terminologia:
- down é o momento que a tecla é apertada
- up é o momento que a tecla é solta
| Variável | O que é | Unidade |
|---|---|---|
| dwell_ms | quanto tempo uma tecla fica pressionada, do down ao up dela mesma | ms |
| flight_dd_ms | de um down ao down seguinte (ritmo de tecla a tecla) | ms |
| flight_ud_ms | do up de uma tecla ao down da próxima (o “vão” entre elas) | ms |
Um bigrama é um par ordenado de teclas, tipo (A, S). É nele que o flight mora: o tempo entre a primeira e a segunda. Um trigrama é o mesmo conceito, mas usando uma sequência de 3 teclas.
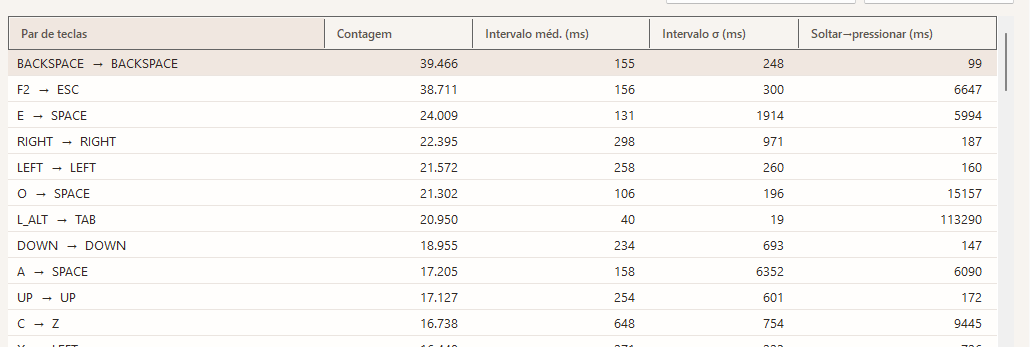
Exemplo da coleta de bigramas
Para o mouse coletamos 13 variáveis de movimento. As medidas de distância e velocidade são normalizadas em frações da diagonal da tela, para não dependerem de monitor nem de resolução; as demais são tempos, contagens, razões e ângulos. Essas informações não foram utilizadas nessa análise, porque dois dos quatro participantes usam uma versão do app anterior à coleta de movimento e simplesmente não as têm.
Terminologia:
- Fração da diagonal. As distâncias percorridas não são medidas em pixels. Cada deslocamento é dividido pela diagonal do monitor em que ele aconteceu, d = √(dx² + dy²) / diagonal. Assim, atravessar metade da tela vale 0,5 num notebook e 0,5 num monitor ultrawide – isso não garante que temos invariância dessa medida entre diferentes monitores para o mesmo usuário, mas já melhora a medida
- Traço (stroke). Sequência contínua de movimento, fechada quando o mouse fica parado por mais de 150 ms. É a unidade natural de “um gesto”: pegar o ponteiro, levar até um alvo, parar
Variáveis coletadas por segmento, dentro de um traço
| Variável | Definição | Unidade | Faixa do histograma |
|---|---|---|---|
| speed | velocidade instantânea, d / dt | diagonais por segundo | 0 a 4 |
| accel | aceleração, a variação da velocidade. Tem sinal: negativa quando o movimento freia | diagonais por s² | -200 a 200 |
| jerk | a variação da aceleração. Mede o quanto o movimento é brusco em vez de suave | diagonais por s³ | -2000 a 2000 |
| angle | direção absoluta do segmento | radianos, -π a π | -π a π, faixas de 10° |
| turn | mudança de direção entre um segmento e o seguinte | radianos, 0 a π | 0 a π, faixas de 5° |
| curvature | turn / d, o quanto a trajetória vira por unidade de distância percorrida | radianos por diagonal | 0 a 500 |
Variáveis coletadas por traço
| Variável | Definição | Unidade | Faixa |
|---|---|---|---|
| stroke_ms | duração do traço | ms | 0 a 6000 |
| path_efficiency | deslocamento em linha reta dividido pelo caminho realmente percorrido. Vale 1 num movimento perfeitamente reto e cai quanto mais o trajeto serpenteia | razão, 0 a 1 | 0 a 1 |
| micro_corrections | quantas reversões bruscas (virada maior que 135°) aconteceram dentro do traço. É o “passei do alvo e voltei” | contagem | 0 a 40 |
| pause_ms | o intervalo parado entre dois traços | ms | 0 a 2000 |
Variáveis relacionada ao clique
| Variável | Definição | Unidade | Faixa |
|---|---|---|---|
| click_interval_ms | tempo entre um clique e o seguinte | ms | 0 a 3000 |
| velocity_at_click | a velocidade do ponteiro imediatamente antes do clique (janela de 200 ms). Mede se a pessoa para no alvo antes de clicar ou clica ainda em movimento | diagonais por segundo | 0 a 4 |
| movement_onset_ms | o tempo entre um estímulo de input e o começo do movimento. É o atraso de reação antes do gesto | ms | 0 a 1500 |
Os dados
Até hoje o servidor tem 976 sessões em 4 identidades, registradas de 9 de agosto a 17 de outubro de 2026. Duas dessas identidades são minhas - meu uso em computador pessoal e corporativo. As outras duas são colegas de trabalho que toparam participar. Sei quem são as pessoas, mas não tenho como identificar quem é quem nos dados.
Sobraram 14 variáveis, todas tiradas dos histogramas: média, desvio, mediana e intervalo interquartil do dwell e do flight_dd, mais o dwell médio de seis teclas individuais (ESPAÇO, A, E, O, S, C). Das 976 sessões, 438 passaram no filtro de ter pelo menos 200 amostras de cada tipo e as seis teclas com pelo menos 20 amostras cada.
Cada sessão de coleta é um ponto em um espaço de 14 dimensões. Foi aplicada a técnica de escalonamento multidimensional para projetar esse espaço em um plano (padronizando as variáveis), para avaliarmos se conseguimos encontrar clusters de uso por identidade – e conseguimos um bom resultado nessa primeira análise.
Metodologia
- Escalonamento multidimensional para reduzir a dimensão dos dados (de 14 para 2 variáveis). Não é um passo necessário para o objetivo do estudo, mas é um bom método para vermos se conseguimos visualizar os dados e a separação entre identidades
- 1-NN, leave-one-out. Esse foi o primeiro teste da hipótese: os dados coletados separam diferentes identidades de uso? Conceitualmente o teste é simples: para cada sessão, procuramos a mais próxima no espaço completo de 14 variáveis, e avaliamos se ela pertence à mesma identidade. Como os dados são muito desbalanceados (muitas sessões minhas, poucas dos outros participantes), em vez de rodar na base toda sorteei 65 sessões de cada um dos três participantes com volume suficiente e repeti o sorteio 500 vezes. Com três grupos do mesmo tamanho, quem chuta acerta 1 em 3, ou seja 33%. Resultado: a vizinha mais próxima pertence à mesma identidade em 99,9% dos casos, e nunca abaixo de 99,0% em nenhum dos 500 sorteios. A hipótese inicial se sustenta
- Encontrando os grupos. Aqui aplicamos o k-means para avaliar se os grupos aparecem nos dados sem a informação da identidade. Para cada k entre 2 e 6 avaliamos a qualidade da separação pela silhueta, que para cada sessão compara a distância média até o seu próprio grupo com a distância média até o grupo vizinho mais próximo: perto de 1 a sessão está bem acomodada, perto de 0 está na fronteira, e negativo quer dizer que ela está mais perto de outro grupo que do seu. Comparamos cada solução com as identidades reais pelo índice de Rand ajustado (ARI), que vale 1 para concordância total e 0 para o que o acaso daria.
| k | silhouette | ARI vs identity |
|---|---|---|
| 2 | 0.549 | 0.449 |
| 3 | 0.572 | 0.531 |
| 4 | 0.539 | 0.809 |
| 5 | 0.545 | 0.786 |
| 6 | 0.387 | 0.489 |
Qualidade da separação por k. A silhueta é melhor em k=3; a concordância com as identidades reais é melhor em k=4.
Análises
O teste do 1-NN resultou em acerto de 99,9%. Isso, em machine learn, é um sinal de alerta – em geral resultados muito bons são indicadores de erros de metodologia e não de um modelo perfeito. Para tentar contornar essa dúvida levantamos três hipóteses que poderiam causar esse efeito e invalidar o estudo.
(H1) Adjacência temporal. A sessão mais próxima encontrada no 1-NN é no mesmo dia da sessão em análise, para mesma identidade.
Se for verdade – o modelo está indicando a próxima sessão do mesmo usuário. Duas sessões adjacentes tem altas chances de compartilhar mesmo estilo de digitação, uso do mouse, cansaço do usuário. Nesse cenário a conclusão que poderia ser tirada dos dados é que os usos em uma mesma tarde se parecem uns com os outros
O teste mostrou que não é o caso: apenas 5,7% das sessões mais próximas são do mesmo dia, e a distância mediana entre uma sessão e a sua vizinha mais próxima é de 293 horas, cerca de doze dias.
(H2) Versionamento. Durante o desenvolvimento do app várias versões do formato de coleta foram armazenadas. Além de novas variáveis, a mesma variável pode ter sido medida de formas ligeiramente diferentes conforme o app evoluiu.
Se for verdade – a conclusão é que a separação encontrada é um proxy da forma de medição, não da identidade do usuário.
Na análise os dados ficaram restritos à versão 1.7.0.0, a única compartilhada por todos os três participantes. Ainda assim o teste do 1-NN resulta em 98,8%.
(H3) Teste reverso. H2 questiona se ao remover versões distintas do app a hipótese se sustenta. A H3 é o inverso: a versão do app tem algum poder de separação? Para esse teste, em vez de usar as identidades como alvo do 1-NN, uso várias medidas de versionamento do app dentro de um mesmo usuário (ou seja, o teste roda só com os meus dados). Incluí também o mês da coleta, que serve como controle: um mês não tem como mudar a forma de medir.
Se for verdade – ou seja, para um mesmo usuário, a versão do app for facilmente identificável, então versão é um eixo forte nesse espaço e a separação entre participantes volta a ficar sob suspeita – pode haver viés na coleta de dados devido à versão.
| Rótulo | 1-NN | Acaso | Excesso |
|---|---|---|---|
| Versão do app | 33,2% | 23,6% | +9,6 pp |
| Versão do schema de coleta | 52,3% | 40,2% | +12,1 pp |
| Mês da coleta | 47,3% | 35,6% | +11,7 pp |
A versão do app separa quase nada: 9,6 pontos percentuais acima do acaso. Ela não tem força para explicar os 99,9%, e a H3 também não se sustenta.
Sobra explicar o resíduo. O mês da coleta separa tanto quanto as versões, e um mês não muda a forma de medir. Como versão do app, versão do schema e mês são proxies da mesma coisa, o tempo, a conclusão é que esse resto não é medição: entre setembro e outubro o meu padrão de digitação se deslocou. Existe um drift natural, que também precisa ser modelado.
Com as três hipóteses descartadas, seguimos com a análise. Nenhum valor de k produz um grupo por identidade. Em k=3, onde a silhueta é melhor, ele junta as minhas sessões com as de um dos participantes e gasta o terceiro grupo separando um subconjunto das minhas próprias sessões. Em k=4, que é o que mais se aproxima dos rótulos reais, ele continua gastando um grupo inteiro com esse mesmo subconjunto.
Esse subconjunto não é um segundo jeito de eu digitar: é um jogo (literalmente, Hollow Knight: Silksong). Nessas sessões a tecla C fica pressionada 213 ms contra os meus 68 ms habituais, o S vai de 71 para 103 ms, e ESPAÇO, E e O não mudam nada. Elas também têm um terço dos cliques por tecla. É WASD com agachar, não digitação. A consequência é desconfortável: ao longo do eixo principal, a minha própria variação por mudança de atividade é maior que a distância entre mim e outro participante.
O gráfico 1 mostra o resultado: as quatro identidades (três pessoas, já que duas das instalações são minhas) projetadas em duas dimensões. As minhas sessões de jogo aparecem esticando o meu grupo para a direita, e as quatro sessões do meu notebook corporativo não caem perto das minhas de casa, e sim na borda do grupo de outro participante. São poucos pontos para concluir sozinho, mas apontam para a decisão que eu já tinha tomado no começo do projeto: identidade aqui é usuário mais setup, não usuário.
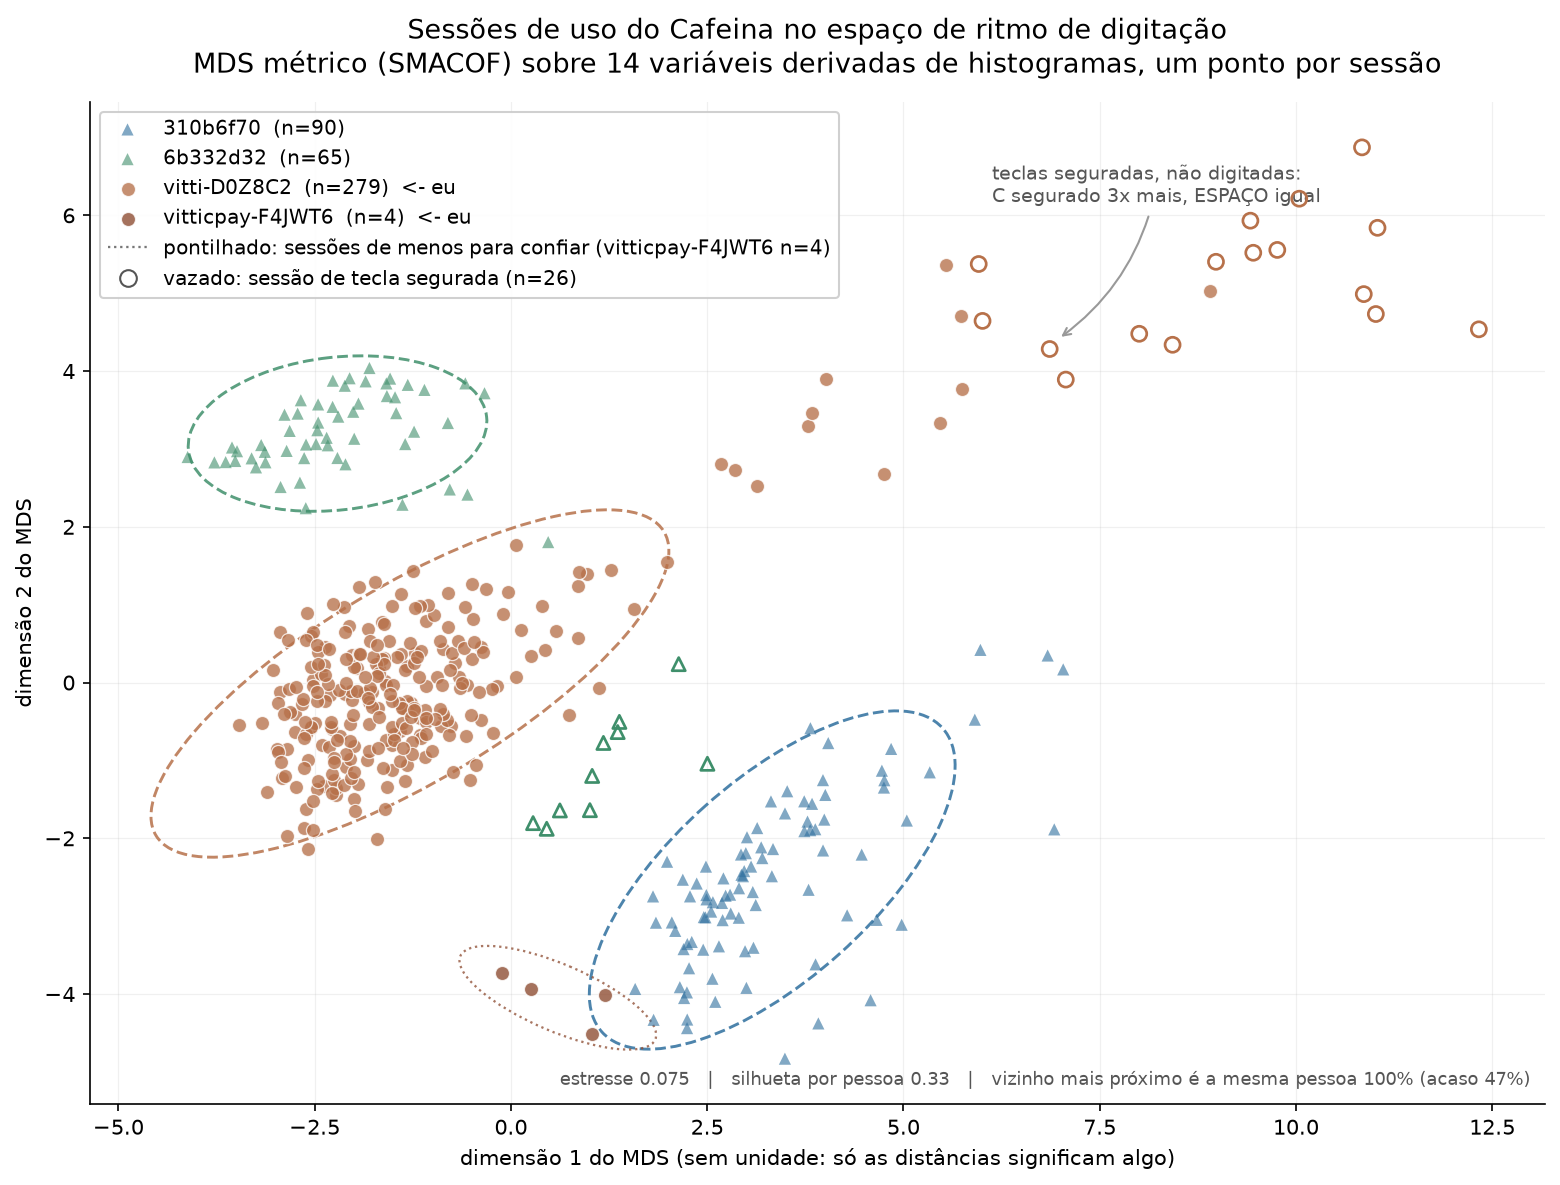
Gráfico 1. Cada ponto é uma sessão. Pontos vazados são as sessões de tecla segurada; as elipses cobrem dois desvios padrão apenas da digitação normal.
Conclusões
O ritmo de digitação, sozinho, tem poder de separação das identidades analisando dados de uso real, sem controle de tarefa (i.e., o usuário faz o que está fazendo, não sabemos a tarefa sendo realizada) e sem nenhum texto pré-definido.
Separar quatro instalações conhecidas, porém, é bem diferente de reconhecer uma pessoa. Três coisas estão misturadas nos grupos: a pessoa, a atividade e o hardware. Enquanto trocar de atividade move um ponto mais do que trocar de pessoa, qualquer sistema que agisse sobre “esse não parece você” dispararia quando o usuário legítimo abrisse um jogo.
O teste também é fechado: ele escolhe entre identidades conhecidas. O problema real é aberto, “é você ou não é”, com um limiar, a opção de recusar, e um desconhecido que nunca entrou na base. São problemas diferentes, e o segundo é bem mais difícil.
Uma das ideias que motivou essa análise, bloquear a máquina sozinha ao detectar divergência, não se sustenta apenas com essas variáveis. A regra mais frouxa que ainda detectava alguma coisa bloqueava o usuário legítimo quase duas vezes por dia.
Como próximos passos:
- Coletar mais dados. Trazer mais participantes para o projeto para termos um espaço paramétrico mais rico para as análises
- Definir melhor o baseline por dispositivo. O app já registra qual teclado físico gerou cada sessão. A análise não usou essa informação porque temos poucas sessões com essa informação preenchida
- Drift. Avaliar como modelar o drift de uso para o mesmo usuário
Quer participar?
Faça o download do app em cafeina.lucas.mat.br e entre em contato comigo para receber uma chave de autorização de upload dos dados.